対応分析ガイド
地域・年代・話題などの文書タグを使い、グループごとの語の使われ方を比べます。
このガイドはログインせずに読めます。
比べる単位とタグをそろえる
例えばアンケートの回答者を年代別に分け、使う語にどのような違いがあるかを探します。対応分析はライトプラン以上で利用できます。Open Betaの対象期間中も利用できます。
- 1回答・1記事など、研究の目的に合う単位で文書を登録します。複数の記事を含む新聞1ページは、1記事とは異なる単位です。
- 「20代」「30代」「40代」「50代」のように、同じ観点の文書タグを2〜20個用意します。年代と地域を同時に選ばず、観点ごとに分析します。フォルダ・タグの管理で準備できます。
- 先に同じ対象文書・辞書で頻度分析を完了してください。対応分析で選ぶ語の形の集計も必要です。保存済みの文書別件数を再利用するので、語の切り分けからやり直す必要はありません。
文書や辞書を変更した場合や、必要な文書別集計がない古い結果の場合は、頻度分析をやり直します。詳しくは頻度分析ガイドをご覧ください。
トピック分析やAI文書分類からタグを作る場合は、代表文書を読んで分類の意味を確かめます。同じ文章から作った分類を対応分析で見直す作業は、話題を整理するための探索です。分類の正しさを独立に証明するものではありません。
分析条件を選ぶ
プロジェクトの分析メニューから「対応分析」を開きます。頻度分析が不足している場合は、表示される「頻度分析を実行する」から準備します。
- 「属性名」に年代や居住地域などを入力し、「グループにする文書タグ」を選びます。各グループの文書数を確認してください。
- 「数える語の形」を選びます。表記そのままか、辞書の基本形を使えます。
- 「集計方法」を選びます。出現回数は同じ文書での繰り返しを含み、出現文書数は同じ語を1文書につき1件と数えます。長い文書内の繰り返しの影響を抑えたい場合は、出現文書数が選択肢になります。
- 「分析に使う語」「最小出現文書数」「最大語数」を指定します。初期値は名詞のみ・3文書以上・最大200語です。最大語数は1,000語までで、選んだ集計方法の件数が多い順に採用します。
- 対象・未分類・重複の件数を確かめ、「対応分析を実行」を押します。完了したら分析履歴から結果を開きます。
1文書に選択中のタグが複数付いていると、そのままでは実行できません。タグを見直すか「選んだタグが重複する文書を除外する」を指定します。タグのない文書は初期設定では対象外です。「未分類」として含めることもできます。除外による対象の偏りと件数を記録してください。
集計に使える語を持つグループが2つ以上、語が2語以上必要です。語の構成比が同じ場合は図の軸を作れませんが、集計表で件数を確認できます。
分布図で傾向を探す
 画像を拡大
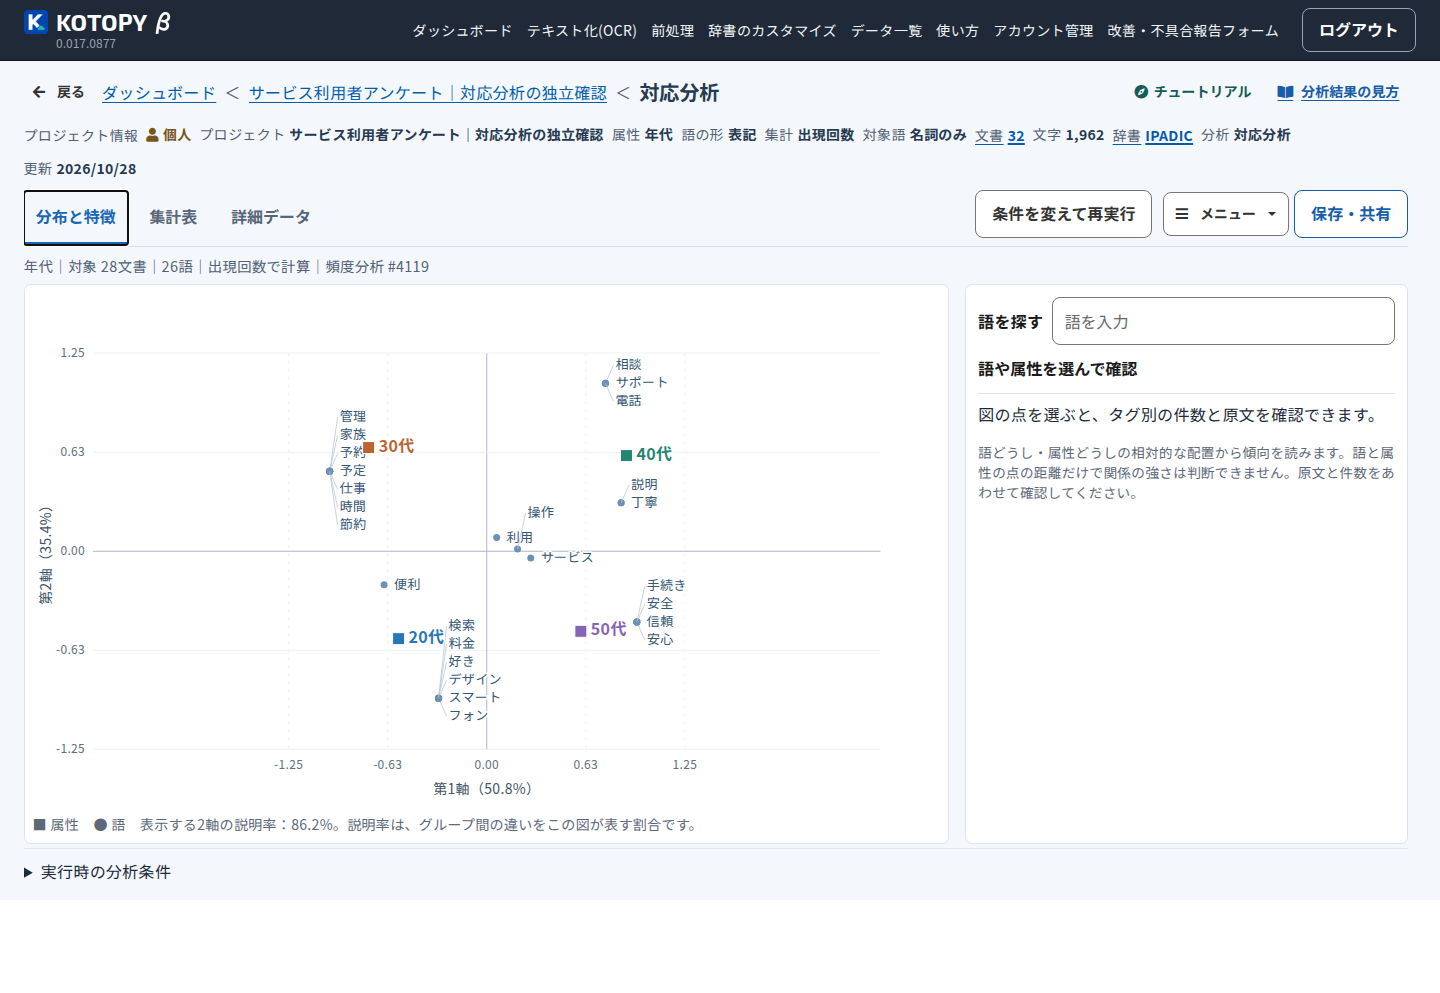
「分布と特徴」の四角はタグのグループ、丸は語です。語どうし・グループどうしの配置から、使われ方が似ているかを探します。語とグループの点の距離だけで、関係の強さを判断しないでください。
「メニュー」→「グラフの操作」で横軸・縦軸や語のラベル数を変えられます。「語を探す」で注目語を選び、タグを選ぶと、そのグループで全体に比べて割合が高い語を確認できます。ラベル数の変更は、計算に使う語数を変更しません。
図の下の説明率は、表示した軸が語の構成比の違いをどれだけ表すかです。正しさや信頼度ではありません。2グループなら最大1軸、3グループなら最大2軸となるため、説明率100%でも分析の妥当性を証明するものではありません。
「詳細データ」では固有値・説明率・座標・寄与度・cos²を確認できます。寄与度はその軸を特徴づける割合、cos²はその点の違いを軸が表す程度(0〜1)です。対象・寄与度またはcos²・軸・大きい順/小さい順を選び、属性と語それぞれの中で並べ替えられます。表示軸のcos²が低い点は、図だけで解釈しすぎないようにします。
集計表と原文で確かめる
「集計表」で、出現回数・出現文書数・割合を切り替えます。数値を選ぶと、その語が使われた原文を確認できます。否定表現、引用、同じ語の別の意味にも注意します。
- 語の中での割合:その語の全グループの件数を分母にします。
- グループの中での割合:そのグループで分析に採用した全語の件数合計を分母にします。グループの文書数を分母にした割合ではありません。
- 文書の出現割合:「表示する値」で選べます。その語を含む文書数を、実行時のグループ文書数で割ります。対象語がない文書も分母に含みます。図でも「7 / 10文書に出現(70.0%)」のように確認できます。1文書に複数の語が出るため、語ごとの割合を足しても100%にはなりません。
「語の中」「グループの中」の割合は、実行時に選んだ集計方法を使います。「出現回数」から「出現文書数」へ集計表の表示を変えても、図の計算条件は変わりません。計算から変更する場合は「条件を変えて再実行」を使います。
条件と結果を研究記録に残す
「保存・共有」から表をCSV・Excel、図をSVG・PNGで保存できます。「研究用データ一式」を選ぶと、計算に使った表、出現回数・出現文書数・文書の出現割合(分母付き)、固有値・説明率、座標・寄与度・cos²、分析条件をまとめて保存できます。Excelは8つのシート、CSVは「表・行・項目・値」の縦長形式です(行0は列名)。画面の検索・並べ替えにかかわらず全採用語・全軸を保存します。未記録の条件は現在設定で補わず「未記録」とします。
「実行時の分析条件」も開き、対象文書、タグの定義、重複・未分類の扱い、辞書、語の形、集計方法、品詞・除外語、最小出現文書数、最大語数、参照した頻度分析を記録してください。
「AIと読み解く」では、選択中の語・属性や表示軸について質問できます。AIは保存された件数・分母・説明率・寄与度・cos²を参照します。原文の準備が済んでいる場合は、対象文書の用例も確認できます。回答の根拠を開いて確かめてください。原文が未準備でも集計結果について質問でき、AIクレジットを使用します。
報告には使用した軸と説明率、特徴を判断した件数や寄与度、根拠となる原文を添えます。少数の語やグループに引っ張られていないか、条件を変えた場合にも傾向が保たれるかを確認します。
この結果から言えること:選んだ文書・語・タグの範囲で、語の使われ方にどのような違いが見えるかを説明できます。有意差、因果関係、母集団全体への一般化は、分布図だけでは判断できません。
複数属性を同時に扱う多重対応分析、補助点の投影、有意差検定はこの画面では行いません。必要な場合は、保存した集計表や元データを目的に合う統計手法で分析してください。計算方法と論文記載例も参照できます。